管理学爱引用的心理学实验,复现只剩36%
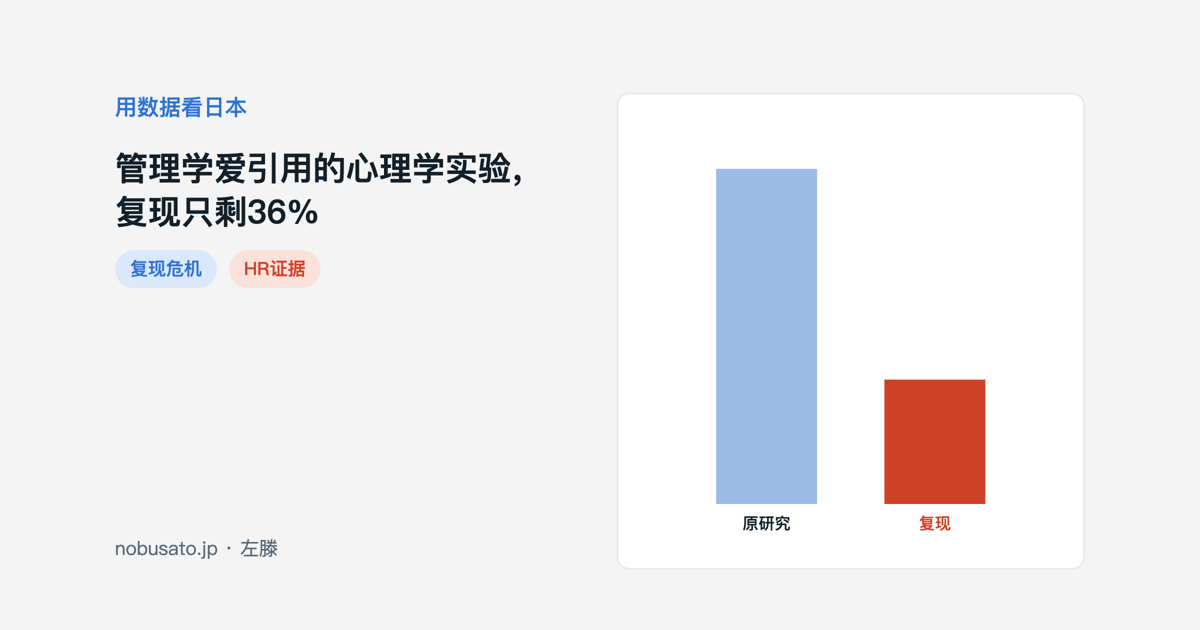
原本97%都「显著」的100项心理学研究,换一批人照原样重做,只剩36%还显著,效应大小平均砍掉一半。这是2015年《Science》上的结果。管理课上常讲的那些经典实验,就出自这个学科。
常见的一种情况是,老板在一门课上听到某个实验,回来就把它做成选人标准或考核规则。这个坑不大,但很贵:在日本,选错一个法人负责人,换人通常要6到12个月,猎头费率也远高于常见的年薪30%左右。所以今天把几个最常被引用的实验拿出来,对着原论文看看还剩多少。
100项研究重做,剩下多少
答案是36%。Open Science Collaboration 在2015年发表于《Science》第349卷的「Estimating the reproducibility of psychological science」,是一项大规模协作复现:从三本心理学主流期刊2008年刊登的论文里选出100项实验和相关研究,尽量用原作者的材料,用统计功效更高的设计重做。整个项目从2011年11月做到2014年12月。
原研究里报告显著结果(p<.05)的占97%,复现后只有36%显著。原效应量落在复现95%置信区间内的占47%,研究者主观判断「复现成功」的占39%。平均效应量折成相关系数 r,从0.403降到0.197。
Fig.1Open Science Collaboration(2015)重做三本心理学期刊的100项研究,显著结果的比例从97%降到36%,平均效应量 r 从0.403降到0.197。
这组数字有边界。100项研究不是从整个心理学里随机抽的,是三本期刊、一年的论文里挑出能重做的。分领域看差别也大。按同一篇论文的拆分,认知心理学的研究复现后仍显著的是50%(42项里21项),社会心理学只有25%(55项里14项)。所以「心理学六成是假的」这种说法站不住。论文自己的结论是,能不能复现,主要看原研究的证据本身硬不硬,跟谁来做关系不大。问题出在大家把单个「显著」结果信得太满。
为什么一重做就缩水?主要是发表偏差:有结果的论文容易登,没结果的压在抽屉里。小样本碰巧做出大效应,就被登出来了;换人重做,运气没了,效应自然变小。
老板们最爱讲的三个实验,现在什么状态
斯坦福监狱实验。1971年,24名男大学生在斯坦福大学地下室的模拟监狱里分成狱卒和囚犯,原计划两周,6天就叫停。之后几十年,它一直被拿来证明「普通人一掌权就变坏」。法国研究者 Thibault Le Texier 先在2018年出了书《Histoire d'un mensonge》,2019年又在《American Psychologist》第74卷第7期发表「Debunking the Stanford Prison Experiment」。他翻了实验档案,访谈了15名参与者,发现狱卒事先拿到了怎么对待囚犯的具体指令。所谓「自发的恶」,更像是在配合研究者的期待。津巴多一方有过反驳,但这个实验已经很难再当「放任就会作恶」的证据用。「环境影响行为」这个大判断,倒没有因此被推翻。
棉花糖实验。说法是4岁能忍住不吃糖的孩子,长大成绩更好。原始追踪研究 Shoda、Mischel 和 Peake(1990年,《Developmental Psychology》)的孩子来自斯坦福校园里的幼儿园,653人里只追踪到185人,关键条件下算成绩相关的只有35人左右。Watts、Duncan 和 Quan(2018年,《Psychological Science》)用美国全国性追踪调查 NICHD SECCYD 的918个孩子做了概念性复现,换数据、换方法检验同一个关系。等待时间和15岁成绩的相关,只有原研究的一半左右;再控制家庭背景、早期认知能力和家庭环境,又缩掉三分之二。看起来像「自控力」的东西,很大一部分是家庭条件。
自我损耗。「意志力像电池,用了就少,重要决定放在早上做」,源头是 Baumeister 等人1998年的实验。Hagger 等人2016年在《Perspectives on Psychological Science》发表了预注册的多实验室复现,23个实验室、2,141人,效应量 d=0.04,95%置信区间从−0.07到0.15,基本等于零。有人认为他们选的任务太弱,争论还没完。但拿它来设计考核和排班,显然不够硬。
这三个实验有个共同点:没有一个是拿上班的人做的。学生、幼儿园孩子、实验室里的被试,从这里一步跳到「我们公司的销售经理」,跳的那一步是你自己的,不是研究的。
想把「研究表明」写进制度,先过这四关
我自己用的办法很土,就四个问题:
第一,研究的是谁、多少人。大学生、小孩还是在职的成年人,35个人还是几千人。第二,有没有别的团队复现过,最好是预注册的大样本复现。第三,效应有多大,把家庭背景这类因素控制掉以后还剩多少,光看「显著」没用。第四,有没有在真实职场、对在职员工验证过。
四关都过,可以当制度依据。过两三关,当假设,小范围试,用自己公司的数据验证。一关都过不了,培训时讲个故事就行,别写进选人标准。供应商拿着测评工具说「有科学依据」的时候,先问一句论文叫什么。官方数字也一样要问清是谁报的、算了谁,日本加班的两个数字那篇讲的就是这个。
我自己的文章,也请这样读
说句实话,这个网站上我也用了不少经典理论,其中有几个本身就有争议。赫茨伯格双因素理论的原始数据,是1959年在匹兹堡一带访谈203名工程师和会计,让他们回忆工作中特别满意和特别不满的时候。从 King 1970年在《Psychological Bulletin》上的文章开始,一直有人质疑两类因素分得那么开,可能是这种访谈方法本身造成的,那篇文章里我也提过。
邓巴数是从灵长类大脑大小推出来的,邓巴数那篇里我也写了学界的争议。艾伦曲线来自1970年代对研发工程师的观察,那时候还没有企业微信和 Slack。林格尔曼效应的拉绳数据1913年出版,后来 Ingham 等人1974年的实验发现,掉下去的力气,大部分要用动力下降来解释,光靠配合不好解释不了。
我继续用它们,是因为画组织图、拆模块时它们是好用的辅助线。我不把它们当定律,也不会把里面的数字直接拿去定谁的薪水、谁的绩效。读我的文章时拿上面四个问题来问,哪篇过不了关,告诉我。
数据来源
- Open Science Collaboration (2015)「Estimating the reproducibility of psychological science」Science 349, aac4716:显著比例 97%→36%,平均效应量 r 0.403→0.197
- University of Edinburgh 机构库:同一论文全文(47%、39%,认知心理学50%、社会心理学25%)
- Le Texier, T. (2019)「Debunking the Stanford Prison Experiment」American Psychologist 74(7), 823–839:档案研究与15名参与者访谈
- Haney, Banks & Zimbardo (1972)「Interpersonal Dynamics in a Simulated Prison」美国海军研究署技术报告:从75名报名者中选出24人,6天后终止
- Watts, Duncan & Quan (2018)「Revisiting the Marshmallow Test」Psychological Science:918名儿童,相关约为原研究一半,控制后再降三分之二
- Hagger et al. (2016)「A multilab preregistered replication of the ego-depletion effect」Perspectives on Psychological Science 11(4):23个实验室,2,141人,d=0.04
- King, N. (1970)「Clarification and evaluation of the two-factor theory of job satisfaction」Psychological Bulletin 74(1), 18–31
- Britannica「Two-factor theory」(二手资料):Herzberg 1959 样本为203名工程师和会计
- Ingham, Levinger, Graves & Peckham (1974)「The Ringelmann effect: Studies of group size and group performance」Journal of Experimental Social Psychology 10(4), 371–384
- Kravitz & Martin (1986)「Ringelmann rediscovered: The original article」Journal of Personality and Social Psychology 50(5):介绍 Ringelmann 1913 年原文
不够写成一篇的日常想法,我写在 LinkedIn 上。去 LinkedIn 关注我