为什么队伍总是在一瞬间变得很长?
做招聘的人应该都碰到过。候选人来问“后面怎么样了”,总是扎堆来。没人偷懒,简历也没翻倍,只是比平时忙了那么一点,回复就开始按天往后拖。
我排过一次面试。两周,十二个业务部门,四百个面试请求,最后全排完了。按工作日算,一天四十个左右。这种量压上来的时候到底发生了什么,我觉得排队论里最简单的那个模型讲得最清楚。全文就一个公式,跳过去也不耽误往下读。
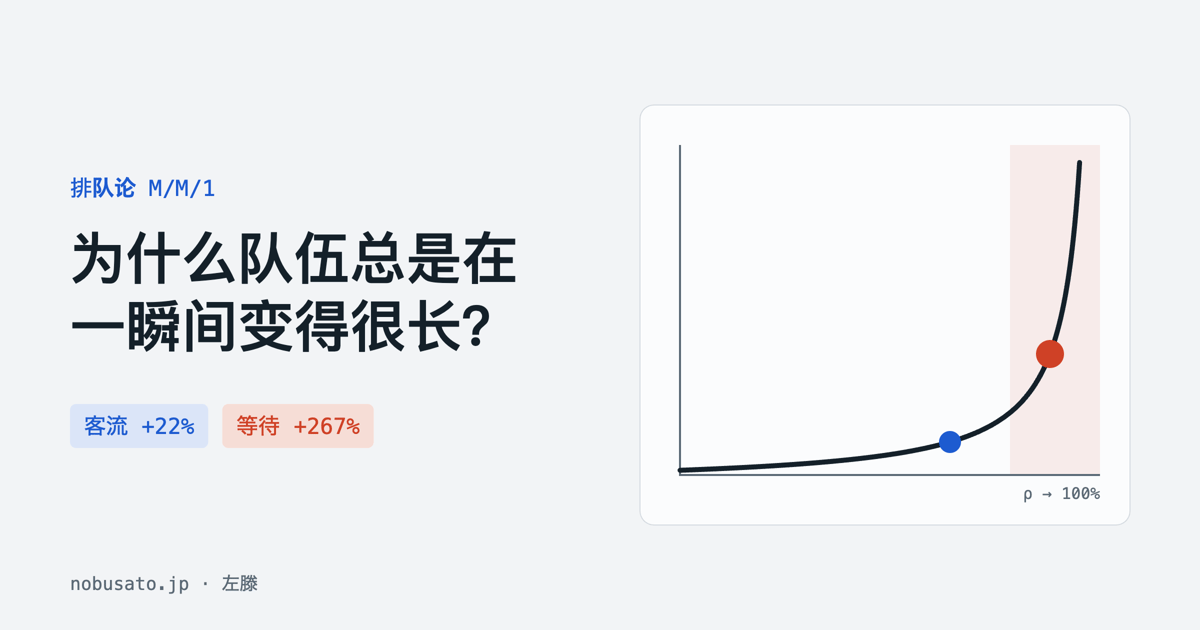
客流只多两成,等待差不多变成四倍
一个店员的咖啡店,产能每小时 60 杯。客流每小时 45 人与 55 人时的平均等待(分钟)
- 现在每小时 45 人3 分钟
- 促销后 · 直觉“多个两三成”4 分钟
- 促销后 · 模型M/M/1 计算11 分钟
直觉按负荷等比例估算。真实的等待,是在余量耗尽的地方突然跳上去的。
先看一家咖啡店
一家咖啡店,一个店员。平均一分钟做一杯,一小时六十杯。上午每小时平均来四十五个人,产能还空着四分之一。
老板搞了个促销,客流涨到每小时五十五人,多了 22%。你大概会觉得,排队时间也就多个两三成吧。真算出来,平均等待从 3 分钟变成 11 分钟。差不多四倍。
四倍是怎么来的
两个原因。顾客不是匀着来的。店员闲下来的时间,也存不起来。
下面这张图,是某 24 分钟里进门的 16 个人。平均每分钟不到一个,可总有三个人前后脚进来的时候,队就是那会儿排起来的。同样这 24 分钟,加起来有 8 分钟店里一个客人都没有。这 8 分钟的产能,没法挪到后面的高峰去用。
店里明明有空着的时候,队照样排起来
一个店员、平均一分钟一杯,某 24 分钟里进门的 16 个人
- 01顾客不是匀着来的平均每分钟不到一个,可总有三个人前后脚进来的时候
- 02队就是那会儿排起来的最多 3 个人同时在排,最长的等了 2.1 分钟
- 03闲下来的时间存不起来这 24 分钟里加起来有 8 分钟一个客人都没有,这些产能没法挪到后面的高峰去用
- 24 分钟里空着的时间浪费的产能8 分钟
平均下来的余量,高峰那一刻用不上。队伍来自到达的波动,和存不起来的空闲。
余量一少,等待就突然变长
写成公式,就是 M/M/1 模型。到达随机,服务时间随机,一个服务台。忙不忙,看利用率 ρ,就是到达速度除以处理速度。平均等待是 ρ/(μ−λ)。分母越接近零,这个数涨得越快。
看数字更直接。处理能力固定在每小时 60 杯。利用率 50%,平均等 1 分钟;80%,4 分钟;90%,9 分钟;95%,19 分钟。从 80% 到 95%,利用率只多了十几个点,等待差不多成了五倍。拖一下滑块,看红点从哪儿开始往上蹿。
利用率过了 80%,等待就开始陡升
M/M/1 模型,处理能力固定为每小时 60 杯。各利用率下的平均等待 Wq(分钟)与平均排队 Lq(人)
- 50%轻松区,排队 0.5 人1 分钟
- 80%拐点,排队 3.2 人4 分钟
- 90%陡坡,排队 8.1 人9 分钟
- 95%崩溃边缘,排队 18.1 人19 分钟
利用率只多了十几个点,等待差不多成了五倍。
真实的队伍,比平均值乱得多
公式算的是平均数。真实的队伍,会安静一阵,突然变长,然后很久才消下去。下面这个模拟,顾客按随机数进门。把客流调到每小时 54 人左右,看一会儿。那种乱,光看平均数是看不出来的。跑得久了,实测的平均等待会慢慢贴近理论值。
平均等 9 分钟,不等于每个人都等 9 分钟
M/M/1 模型,客流每小时 54 人(利用率 90%),处理能力每小时 60 杯。理论平均等待 9 分钟
- 01安静一阵基本不排队
- 02突然变长几个人接连进门,队一下子就长了
- 03很久才消下去空闲存不起来,排长的队只能慢慢消
- 理论平均等待每小时 54 人时9 分钟
实测的平均,要跑得够久才贴近理论值。真正的等待,都挤在队突然变长的那几段。
放到招聘里看
说回招聘。招聘官桌上的活,几乎全是排队:约面试时间,给候选人回消息,等用人部门拍板,走 offer 审批。活随机来,干活的人就那么几个。十二个部门提需求,各有各的节奏,到达基本就是随机的。
我见过的招聘团队,很多是按利用率管的。谁手上还有空,就再塞一个职位给他。坑就在这条曲线上。负荷过了九成的团队,再加一个职位,全队的回复都会慢下来。你们多忙,候选人不会记得。他只记得自己等了几天。
还常听人说:“利用率 90%,还有一成余量。”按平均算,没错。可这时候平均排着 8 个多人,是 50% 时的 16 倍。
加不了人,那就减波动。比如每周一开头,就把面试时段整块锁死;需求单统一格式,让每件事花的时间差不多。产能一分没多,整条曲线却能往下压一截。不过波动降不到零。就算处理时间完全固定,只要到达是随机的,平均队长也只减一半。余量还是得留。
有余量的团队,从外面看,有时候像是闲着。我倒觉得,候选人的体验,就是这点空白护住的。留多少合适,不同的活应该不一样,这事我自己也还没想透。真要我给个数,就是曲线开始拐弯的 80% 附近。
模型假设:泊松到达、指数分布服务时间、单服务台、先到先服务。数值按 μ = 每小时 60 杯计算。
候选人真走到面试那一步,我在看什么,写在《过了初筛之后,我在面试里找什么》。日本招聘市场现在有多挤,数字在《日本劳动力市场报告 2026》里。
没写成长文的零碎想法,我会发在 LinkedIn 上。在 LinkedIn 关注我